据报道,谷歌推出视觉-语言-动作(VLA)机器人模型 Gemini Robotics 2.5,称这是其迄今能力最强的一代,大幅提升了机器人可学习的技能广度与速度,也让机器人能走出实验室,进入非结构化的真实环境。
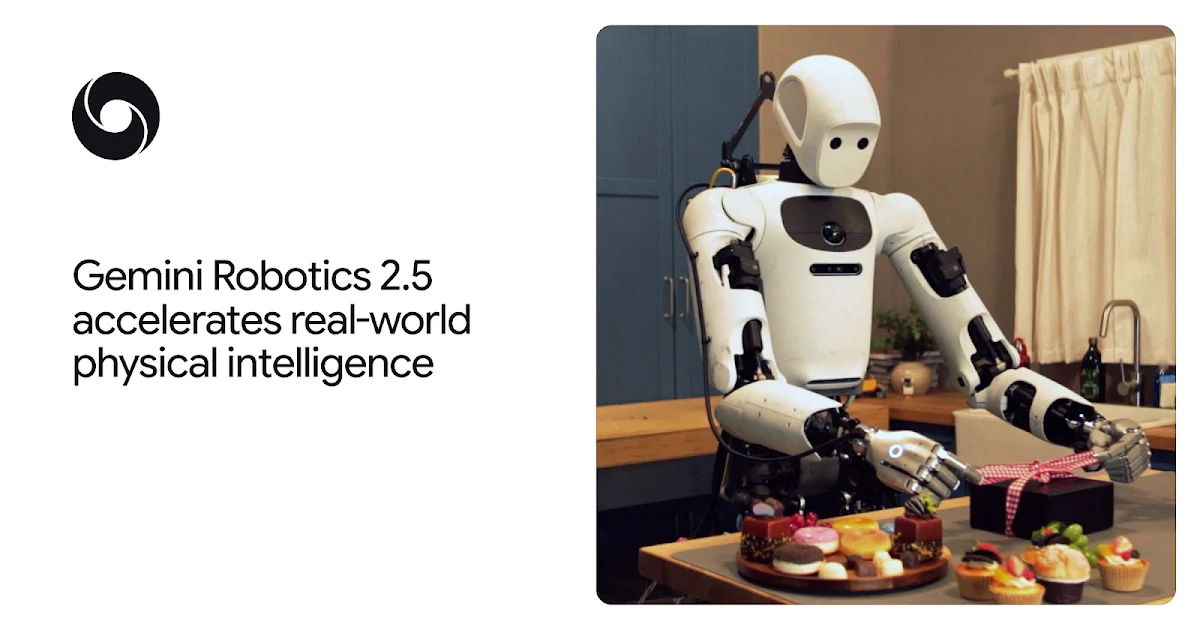
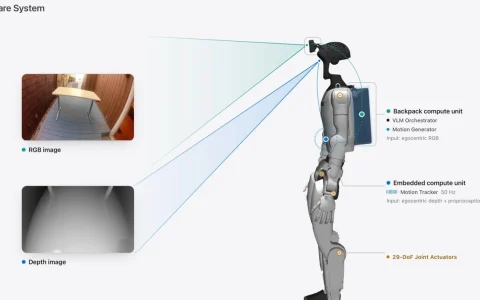
谷歌在超过 200 项任务中测试了这款模型,包括用夹子分发食物、给礼品盒系蝴蝶结、移液操作液体等,这些任务融合了高级工具使用、可变形物体操作和精细处理易碎物品等技能。评估显示,相较此前基线,新模型按任务类型不同成功率高出 30% 至 100%,任务完成速度快 20% 至 30%。它原生适配 Apollo 2 人形机器人与配两指平行夹爪的 Franka Duo 平台。
真实检验发生在奔驰产线。谷歌与 Apptronik、奔驰合作,在匈牙利凯奇凯梅特、德国辛德尔芬根的在用汽车生产线上部署 Apollo 2 测试。机器人要把散料箱中的零部件按线上每台车的确切需求顺序分拣到托盘,谷歌用 Gemini Robotics ER 追踪工作流,由动作模型控制手臂和手部完成取放,并全程修正装配间隙,试点成功率达 96%。
安全方面,模型采用推理时推理引导机制实时规避物理危险,让机器人在障碍物周边的安全任务完成率提升 33%,在人员周边提升 43%。谷歌还发布开源基准 ASIMOV-Jailbreak 测试越狱鲁棒性,Gemini 4 Argon 的抵御率达 99.5%。
此外,Gemini 4 Argon 能生成数千个模拟练习片段构建数字孪生,还能从视频推演任务失败原因,加快新模型开发。Gemini Robotics 2.5 目前正面向谷歌机器人合作伙伴开放。
原创文章,作者:小科同学,如若转载,请注明出处:https://www.kejixun.co/article/767803.html