11月16日,据报道,OpenAI 确认撤销独立机器人团队:机器人研究人员并入核心研究团队,应用机器人与硬件团队转入应用部门。公司表示机器人仍是长期愿景的重要组成部分,此次调整是为了加快相关研发。
放在行业背景里看,这个决定有点反常识。过去这半年,具身智能的投入一直在加码,各家公司都在为下一步扩张做准备。但 OpenAI 的逻辑一贯如此:只做通往 AGI 的最短路径,独立支线做不出差异化,就并回主线。
更值得追问的是另一个问题:通用大模型到底能不能直接干机器人的活?GPT-6 Astra 的发布成了一个节点,行业开始重新划界——哪些任务交给通用模型,哪些必须专门训练。
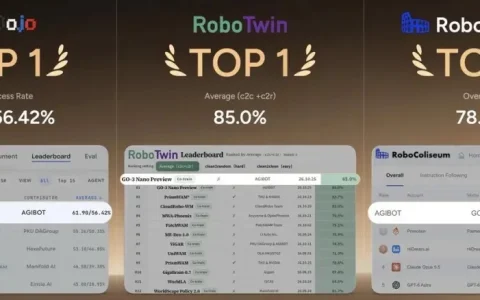
英伟达的 Astranomy 研究给了一组对比。在 RoboLab-120 仿真操作基准中,基于 GPT-6 Astra 的智能体方案成功率 74.8%,高于同研究列出的专用模型 Lakeside 的 51.0%。其中 74.8% 对应带持续交互上下文的方案,直接生成动作的方案为 66.3%。
但这个成绩有边界:测试主要覆盖抓取、放置,推理时仿真环境是暂停的,没有检验在持续变化环境里的实时应对,也没覆盖插接、装配这类复杂接触任务。
Anthropic 那边拿出了另一组数:Claude Fable 5.2 在公司内部运行的 RoboDojo Sim 双臂机器人仿真测试中得分 64.9%,同一框架下 GPT-6 Astra 是 29.8%。两套基准不同,成绩不能直接横向比较。
国内厂商已经在真机上试。宇树创始人王兴兴在 10 月的世界物理 AI 大会上说,物理 AI 已经看到被击穿的苗头,突破可能出现在最近一到三年,现场展示了用 GPT-6 做绘画、规划导航的测试。
优必选试的是两条路。围绕 GPT-6 Astra 做了六组真机与仿真测试,结果是:Astra 直接抓魔方、仿真搬篮子、直接叠碗都没完成;改成与专用具身模型协同后,福袋抓取、绕障移动和叠碗都做成了。
协同方案里,操作交给自研的 Thinker-VLA,决策结合 Thinker-WM 预测动作结果。叠碗测试中,相比直接控制,协同方案的 Astra Token 消耗和 API 估算费用分别减少 83.6% 和 74.2%。
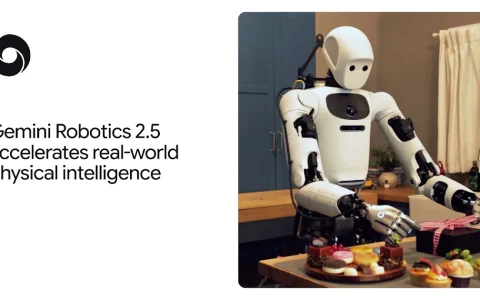
这也说明专用模型没被淘汰。谷歌 11 月 10 日发布的 Gemini Robotics 2.5 是视觉-语言-动作模型,在 200 多项任务中接受评估,覆盖工具使用、柔性物体操作,包括用夹子取放食物、给礼盒系蝴蝶结、移取液体。
谷歌还披露了与 Apptronik、奔驰在汽车产线的概念验证:Apollo 2 人形机器人做零部件拣选与配套作业,成功率达到 96%。分工是具身推理模型跟踪工作流程,Gemini Robotics 2.5 动作模型控制手臂和双手,把零件从料箱取出放进配套容器。
通用模型的作用还在往研发端延伸。谷歌称 Gemini 4 Argon 参与了 Gemini Robotics 2.5 的研发,能根据真实摄像头画面辅助构建数字孪生、生成仿真练习,还能结合任务失败的视频分析原因。
剩下的问题是速度和成本。英伟达研究中,直接控制方案平均每次推理耗时约 18.56 秒;取得最高成功率的智能体方案,每次成功任务的 API 费用估算约 36.4 美元。研究明确指出,延迟和成本是实际应用的重要限制。
所以机器人模型不能只看一个成功率。仿真里的抓取、真机上的叠碗、汽车产线的零部件配套,任务条件不同,结论的适用范围也不同。真实车间里,物体和人不会等模型想完——从「能完成一次」到「按节拍连续作业」,中间隔着响应速度、运行成本,以及出错后的恢复能力。
原创文章,作者:探索频道,如若转载,请注明出处:https://www.kejixun.co/article/768239.html