特斯拉更新了 AI 加速器路线图,把未来几年的芯片方向摊开了。两个关键数字:第六代推理加速器 SI6 的算力预计达到现款第四代芯片的 80 倍;训练用的 Dojo D3 放弃 SRAM 核心架构,改走多芯粒加堆叠 HBM 的路子。
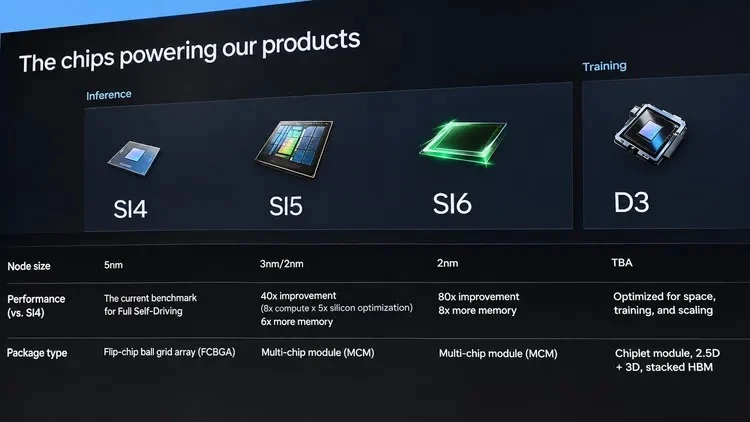
顺带一个命名变化。特斯拉开始用「超级智能」(Super Intelligence,SI)取代「人工智能」(AI),旗下加速器统一归入 SI 系列,马斯克也确认 SpaceXAI 将更名为 SpaceXSI。
先说 Dojo D3。这个项目一度被放弃——马斯克 2025 年 8 月取消了整个晶圆级 Dojo,2026 年 8 月又表示 SpaceX 和 xAI 的地面及太空数据中心将全部采用英伟达硬件。现在 D3 重启,形态和 D1、D2 完全不同:基于芯粒、采用 2.5D 和 3D 封装、搭载堆叠式 HBM。
转向 HBM 的理由很直接。D1 靠分布式片上 SRAM,用晶圆级封装把 25 颗处理器连起来,总共才 11GB SRAM。现代 AI 模型的参数、激活值和中间结果都极吃内存,SRAM 在容量上已经不够看,HBM 扩容要容易得多,代价是延迟、带宽、封装和功耗上的新权衡。
特斯拉没有明说是否彻底放弃晶圆级集成。一种可能是继续用晶圆级封装连接逻辑芯片、再在其上堆定制 HBM;另一种可能是认定晶圆级成本过高,只在 SRAM 主导的架构里才有价值——毕竟在晶圆级互连上叠 HBM 会大幅推高设计、散热和制造难度,拖累良率。从「针对太空、训练和扩展能力优化」这个说法看,走传统芯粒架构的可能性更大。
「太空」这个定语值得单独拎出来。它意味着至少部分型号要具备抗辐射能力,部署场景不只是地面的数据中心。
再看 SI6。算力是 HW4 的 80 倍,内存是 9 倍。按 HW4 约 216~576 TOPS 估算,SI6 大致落在 17280~46080 TOPS,也就是 17.28~46.08 POPS,内存约 144GB。对比之下,英伟达 Rubin 的推理算力是 50 NVFP4 PFLOPS——但 Rubin 已经开始交付,SI6 要等到 2029 至 2030 年。
中间还隔着 SI5。它用 MCM 设计,台积电 3nm 加三星 2nm 双线代工,算力约 HW4 的 40 倍(8640~23040 TOPS),内存 96GB,功耗可能到 250W~800W。SI6 则确定由三星代工、合作到 2033 年,采用 2nm 级制程,可能是汽车级 SF2A、性能增强版 SF2P,甚至带背面供电的 SF2Z。
有个容易被忽略的细节:特斯拉的演示文稿把现款 SI4 的制程标成了 5nm,实际是 7nm。这款由三星代工、FCBGA 封装、配 16GB GDDR6 的芯片被定义为 FSD 的性能基准,但官方从未公布它的绝对算力、内存和功耗,所以上面所有倍数换算都只是估算。
原创文章,作者:Tesla,如若转载,请注明出处:https://www.kejixun.co/article/767512.html