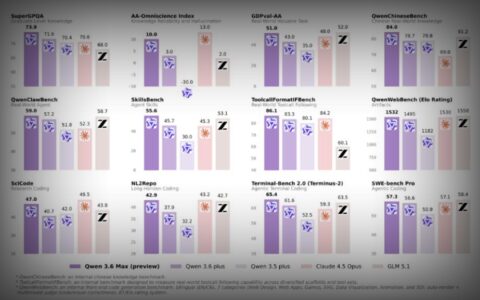
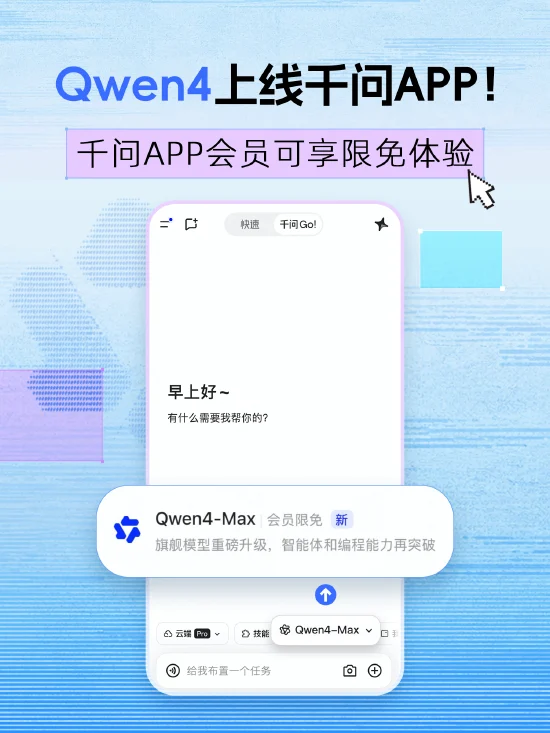
11月17日,据报道,阿里巴巴发布新一代基座大模型 Qwen4-Max,总参数 2.4T,具备原生视觉能力,支持百万上下文。
官方的表述重点没放在跑分上,而是两个方向:智能体和编程能力的持续进化,以及在金融、法律等专业垂直领域从「信息检索」走向「专业交付」。
这两个说法其实是一件事的两面。检索只要求模型找到资料,交付要求它把活干完——中间差的正是长上下文、视觉理解和多步工具调用。
百万上下文和原生视觉是这套能力的地基。合同、财报、图纸这类材料往往又长又图文混排,切碎了喂进去,模型很难建立整体判断,更谈不上交付。商业化上,新模型上线期间千问 App 会员可以限免体验,使用 Qwen4-Max 不消耗会员额度。
从行业节奏看,2.4T 参数的基座模型已经进入「少数玩家才跟得起」的区间。接下来的竞争点,会从参数规模转向单位成本下的交付质量——谁能让模型真正把一件专业工作做完,而不是做完一半。
原创文章,作者:cl-t,如若转载,请注明出处:https://www.kejixun.co/article/768421.html