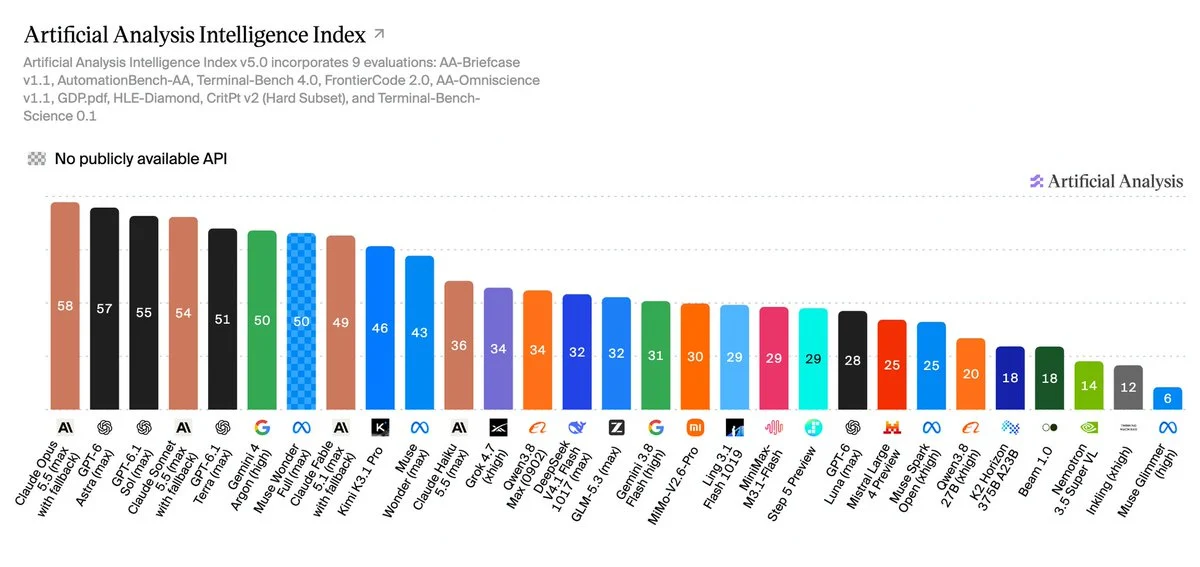
10月29日,据报道,Artificial Analysis 发布 Intelligence Index v5,这是该机构自今年 1 月 v4 上线以来力度最大的一次重构。六成评测权重首次建立在私有测试集或隐藏答案之上,用来压缩公开题库被训练数据污染的空间。
新指数仍由九项评测构成,知识工作、编码、科学、通用能力各占 25%。编码部分里,Cognition 同日发布的 FrontierCode 2.0 独占 15%,Terminal-Bench 4.0 占 10%。FrontierCode 2.0 改了评分口径:132 项任务取自真实开源仓库,提交的代码不再只看单元测试是否通过,而由维护者判断是否愿意合并这个 PR,任何阻塞性检查失败即记零分。
在这一口径下,DeepSeek V4.1 Flash 1017 拿到 28%,是所有已发布权重模型中的最高分。谷歌 Gemini 4 Argon 为 25.7%,GPT-6 Luna 为 25.2%。但综合得分上,DeepSeek 与 GLM-5.3 同为 32 分,仍落后榜首 Claude Opus 5.5 的 58 分。
开源与闭源的距离被拉大了。v4.3 时最强开源模型与榜首差 3 分,v5 换成私有题后差距扩大到 12 分。名义上最强的开源模型是 46 分的 Kimi K3.1 Pro,但权重要到 11 月才发布。
另一个被放大的变量是思考等级带来的成本差:Claude Opus 5.5 从低努力档到最高档相差 23 分,单任务成本从 0.98 美元涨到 10.04 美元,相差约十倍。
原创文章,作者:李小白,如若转载,请注明出处:https://www.kejixun.co/article/766250.html